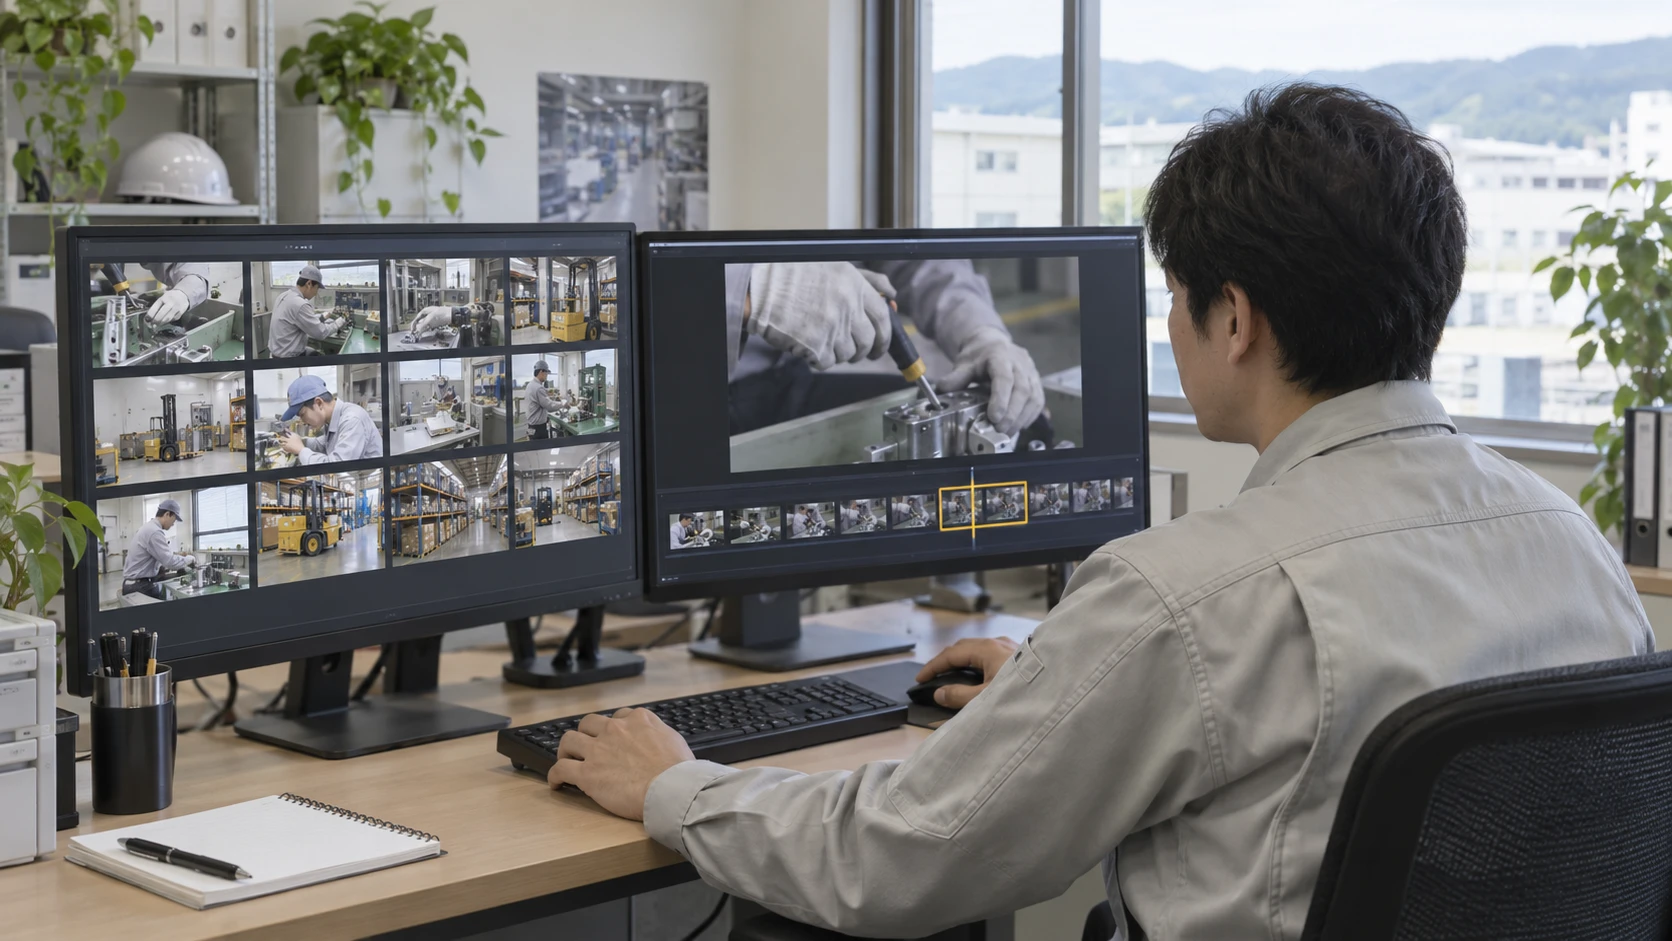
「工具を持ち替えたところだけ見たい」。動画のタイトルにも説明文にも、その場面のことが書かれていなかったら、目当てのファイルを開いて早送りするしかありません。会話を文字起こしして検索できるようにしても、無言の動作は見落とします。
この問題に向き合うのが、映像・音・発話を検索の手掛かりにするマルチモーダル動画検索です。新しい動画を生成する技術ではなく、すでに撮影した映像から使いたい場面を取り出す技術です。
ファイル名ではなく、映っている内容から探せる
2026年9月29日、AWSは出版社Condé Nastの動画検索システムを紹介しました。14万本を超える動画を対象に、自然な言葉や参照画像から関連するクリップと時刻を返す構成です。TwelveLabsのMarengo、Amazon Bedrock、Amazon OpenSearch Serviceを組み合わせています。
AWSの記事は、同社の2026年5月の検証で探索時間が1件250分から約2分になったと報告しています。これは当該企業の測定結果であり、どの動画庫でも同じ効果が得られる数字ではありません。AWSの公開事例
重要なのは速さの数字だけではなく、検索の入口が増えることです。正確なタイトルを知らない人でも、見たい場面を説明する言葉から探し始められます。保管担当者だけが覚えている動画を、ほかの人が発見できる可能性があります。
文字起こし検索と何が違うのか
検索対象の違いを、同じ実演動画で考えてみます。以下は仕組みを説明する想定例で、製品の精度を試した結果ではありません。
| 探したいもの | 有力な手掛かり | 文字起こしだけでは困る理由 |
|---|---|---|
| 「ネジを緩める」と説明した部分 | 発話の文字情報 | 話されていれば探しやすい |
| 作業者が工具を持ち替えた部分 | 映像の動作や物体 | 無言なら文字として残らない |
| アラーム音が鳴った部分 | 音の特徴 | 発話ではない音は説明文にないことがある |
| 手元の写真に近い見た目の場面 | 参照画像と映像 | 外観を言葉にしにくい |
Marengo Embed 3.0の仕様には、映像、音声、文字起こしそれぞれの特徴を取り出す設定があります。テキストや画像も入力にでき、クリップ単位の出力には開始・終了時刻が付きます。
ただし、映像がぼやけている、必要な動作が画面外にある、といった問題まで検索が解決するわけではありません。「内容を手掛かりに探す」と「映っていることを正確に認定する」は別です。
Marengo、Bedrock、OpenSearchはそれぞれ何をする?
Marengoは特徴を数値にする役です。文章や映像の内容を、類似するものを比較するための数値の並びに変換します。これを埋め込み、またはembeddingと呼びます。Bedrockはそのモデルを呼び出すサービスです。
OpenSearchは似ている候補を探す役です。OpenSearchのk-NN検索は、検索用のベクトルに近いベクトルを索引から探します。返された候補と動画の時刻を結び付けることで、ファイル一本ではなく場面に移動できる画面を作れます。
流れを単純化すると、次の二段階です。
- 準備するとき:動画を区切り、特徴を数値化し、動画ID・時刻と一緒に検索用の索引へ入れる。
- 探すとき:質問や参照画像を数値化し、近い場面の候補を探して再生する。
Marengoの仕様でも、動画などの処理には非同期呼び出し、検索文の処理には同期呼び出しを使い分けます。毎回すべての動画を最初から解析するのではなく、準備済みの索引から探す設計です。ただし、新しい動画は準備が終わるまで検索対象に入りません。
ここで得るのは基本的に検索候補です。候補を材料に説明文を生成するには、別の処理が必要です。TwelveLabsのモデル群でも、検索用のMarengoと動画について文章を生成するPegasusは役割が分けられています。AWSのモデル説明
便利になるのは「見る前」より「もう一度使うとき」
ここからは、この仕組みから考えられる使い方です。導入済みの事例として挙げるものではありません。
たとえば、商品の紹介動画を作り直すとき。「前回と同じ担当者の説明」ではなく、「手で組み立てている接写」を探したい場合があります。発話のキーワードより、動作や画角が重要になる仕事です。
研修動画なら、知りたいのは長い講義の要約ではなく、実際の操作を確認できる数十秒かもしれません。検索結果から前後を再生できれば、要約が省いた操作も自分で確かめられます。
この変化は、動画を「順に見る記録」から「必要な場面を取り出して使う資料」へ近づけます。一方、探す場面が決まっていて目次で十分たどれる動画なら、目次を整えるだけで足りる場合もあります。意味検索が常に上位の選択肢なのではなく、タイトル・発話・目次に表れない情報を探したいときに違いが出ます。
自分の動画庫で確かめるなら、何を比べるか
実際に選ぶ段階では、検索時間だけでなく正しい場面を見つけて再利用できるかを比べます。確認したいのは次の三点です。
- 発話で探せる場面と、映像・音が必要な場面を分ける。文字起こし検索で解決する問題を、映像検索の効果に数えない。
- 検索結果の時刻から前後を再生し、対象の動作や説明を確かめる。近そうな候補が出ただけで成功にしない。
- 動画の追加・更新に伴う準備時間と利用料も確認する。検索が速くても、索引作成や管理の負担は残る。
社内の動画なら、閲覧できない映像がサムネイルや抜粋としても漏れない仕組みが必要です。検索モデルを使うだけで動画ごとの閲覧権限が完成するわけではありません。
試すなら、まず人が見つけた正解場面の時刻を控え、同じ問いを目次・文字起こし・映像検索で探して比べます。検索語を調整するための問いとは別に、最後の確認用の問いも残します。判定は次のように分けると、単なる「候補が出た割合」に惑わされません。
| 検索した状況 | 結果の読み方 |
|---|---|
| 正解場面があり、索引も準備済み | 候補から再生して、本当に使える場面か確かめる。似た映像だけなら未発見 |
| その内容を撮影していない | 見つからないことは検索の失敗ではない。無関係な候補を正解にしない |
| 動画はあるが、検索した人には閲覧権限がない | 内容を表示しないことが必要。権限拒否を精度不足に数えない |
| 追加直後で索引作成が終わっていない | 検索精度とは分けて「準備待ち」と記録し、完了後に確かめる |
動画ID、問い、正解時刻、候補時刻、この判定、確認にかかった時間を一行ずつ残せば、今の探し方との差が見えます。発話のない場面を見つけられても、誤候補の確認に時間がかかるなら検索条件を調整する余地があります。目次や文字起こしで同じ場面へ十分早く到達できるなら追加導入を見送り、権限外の映像が出るなら検索の便利さとは別に公開利用を止めて直す、という判断になります。全社共通の合格率や削減額を先に置く必要はありません。
新しさは「AIが動画を要約してくれる」ことだけではありません。言葉にされていなかった映像や音にも、検索の入口を作れることです。大量の動画を持っているかどうかより、今まで見つけられず眠っていた場面が何なのかを考えると、この技術の使いどころが見えてきます。