AIエージェントの仕事は、モデルが応答を生成して終わりとは限らない。コードやツールを使うなら実行環境が要り、その結果を評価して次の改善に生かすこともある。2026年9月30日付のNVIDIA発表は、この本番運用から学習へ戻る流れを、CoreWeaveのクラウド上でつなぐ構想を示した。
ただし、発表された製品がすべて同じ段階で利用できるわけではない。何が本番で動き、何が今後の提供予定なのかを分けて読むと、今回のニュースの意味が見えやすくなる。
いま確認できるのは、NVL72の提供とCognitionの本番利用
CoreWeaveは、NVIDIA Vera Rubin NVL72をSpectrum-X 102.4T EthernetネットワークとともにCoreWeave Cloudで提供すると発表した。資料が明示する利用対象は早期アクセス顧客だ。NVIDIAによると、ソフトウェア開発エージェントDevinを手がけるCognitionが、Vera Rubin上で本番ワークロードを実行する最初の顧客である。Cognitionは以前からCoreWeave上でDevinの学習、強化学習、本番推論を行っているという。
同じ発表には、CoreWeave Forgeの立ち上げと、NVIDIA Vera CPUを今後CoreWeave Cloudで提供する計画も含まれる。つまり、NVL72での本番利用という事例、Forgeという新しい作業環境、Vera CPUの将来提供は、確認できる段階が異なる。
学習・評価・本番推論は、何を受け渡すのか
コードを扱うエージェントを例に、仕組みを概念的に追ってみよう。依頼を受けたエージェントが応答や次の操作を決めるのが本番推論の側面だ。コードやツールを動かす場合は、隔離された環境で実行し、その結果を確かめる必要がある。実行時の挙動や評価結果は、次の学習や評価を考える材料になり得る。入力は依頼や実行課題、出力は応答・実行結果・評価結果であり、改善の段階ではそれらを次の版へどう反映するかが問題になる。
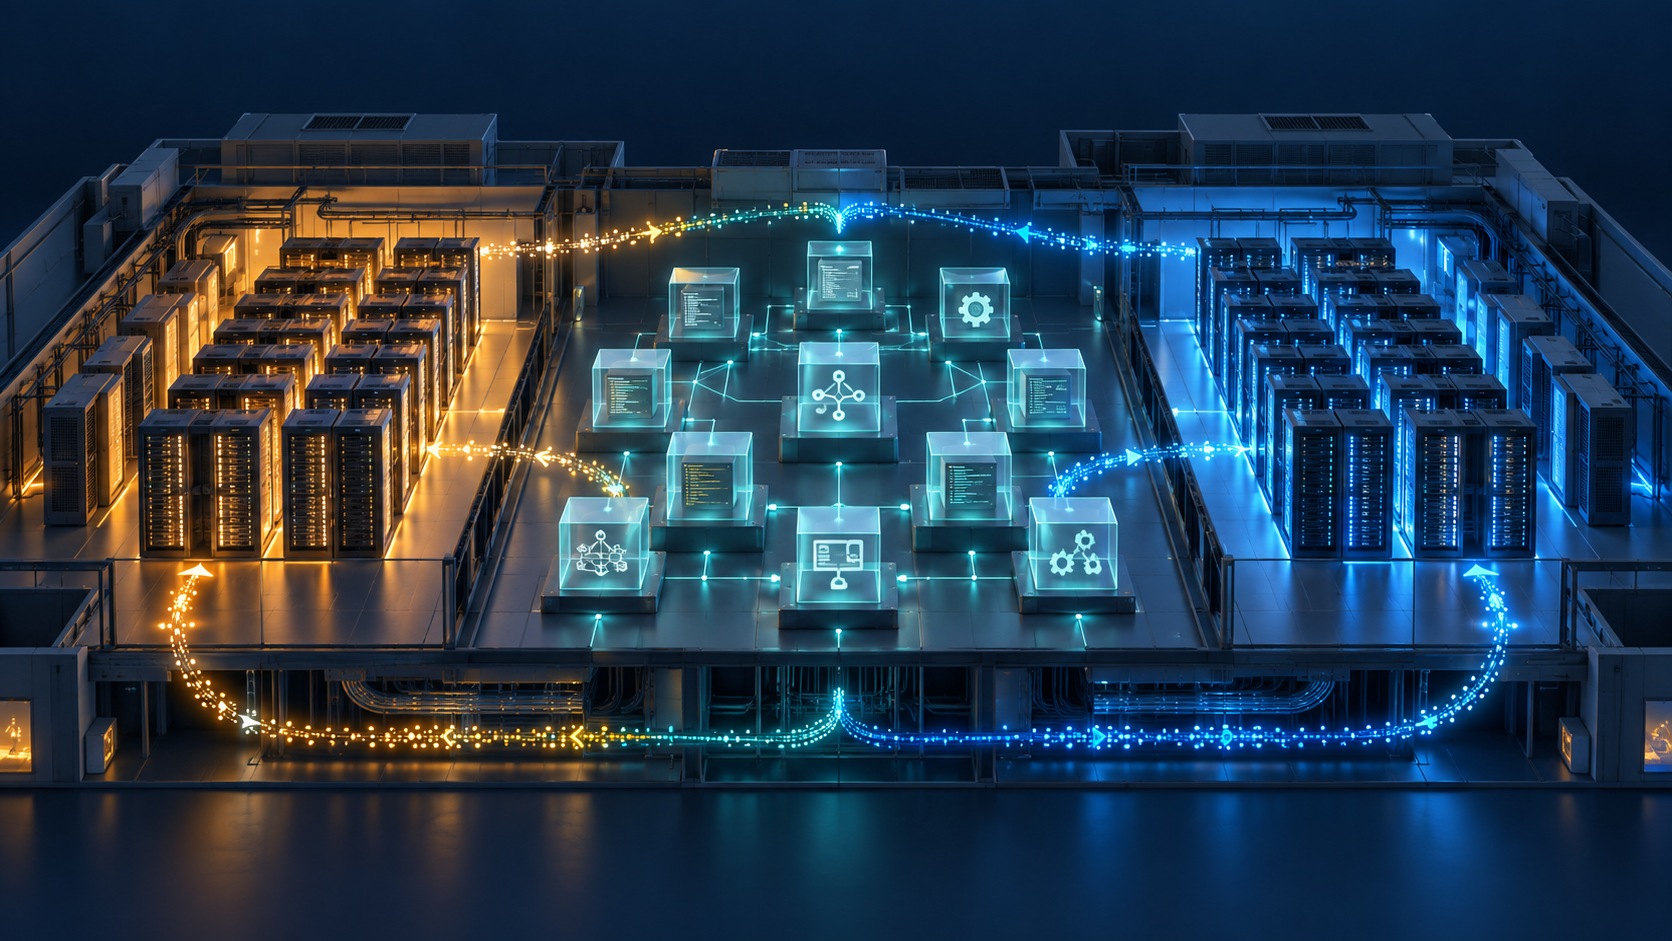
NVIDIAはForgeを、学習、評価、改善をつなぐ環境として位置づけ、本番での挙動が次の学習に情報を与える循環を説明している。一方、提供された抜粋には、CognitionがForgeを使っているという記載も、各段階のデータがどの形式で自動連携されるかという仕様もない。上の流れは仕組みの説明であり、特定顧客の実装を示すものではない。
GPU、CPU、運用サービスの役割は異なる
NVIDIAの製品資料によると、NVL72は72基のRubin GPUと36基のVera CPUを含むラック規模のシステムだ。NVLink 6などでラック内の計算資源を結び、CoreWeaveの発表ではSpectrum-X Ethernetも組み合わせる。GPUによるモデル処理だけでなく、CPU側の仕事とネットワークを含めた基盤として説明されている。
Vera CPUの製品資料が挙げる用途は、コード実行、ツール利用、サンドボックス、データ処理、オーケストレーションなどだ。エージェントの応答を生成する処理と、その周囲で実行環境を用意したり結果を扱ったりする処理を分けて考えると、CPUを強調する理由が分かる。ただし、CoreWeaveで今後提供予定のVera CPUについて、利用条件や提供時期はこの資料からは確定できない。
運用面では、NVIDIAはNVL72の容量をCoreWeave Kubernetes Service、SUNK、Mission Control、Sandboxes、Inferenceを通じて扱えると記している。これは利用者が接するサービスの説明であって、Forgeとのデータ連携方法まで確認できたことを意味しない。
3つの性能値を、エージェント全体の速さに足し合わせない
発表には目を引く数字がある。見出しではCognitionのトークン処理量が4.8倍、Vera CPUのテストではエージェント用サンドボックスの起動が3倍超速いとされる。本文抜粋には、CoreWeaveがTerminal-Benchの通過タスク全体で1.7倍の性能向上を確認したともある。いずれも発表者側の測定結果だ。
この3つは測っているものが違う。トークン処理量は一定時間に扱う出力量、サンドボックス起動は実行環境を立ち上げる処理、Terminal-Benchの値は特定の評価における性能を指す。4.8倍を利用者一人の応答速度とみなしたり、1.7倍を課題の成功率向上と読み替えたりはできない。提供された抜粋だけでは比較対象、構成、測定条件も十分には分からない。
今回の違いは「改善までを一つの流れで扱う」という提案
NVIDIAは、従来は本番運用から学習までの流れが異なる事業者のツールに分かれ、途中で情報が失われやすかったと説明する。今回の提案は、NVL72による本番ワークロード、CPUが担うエージェント周辺処理、Forgeでの評価と改善を、CoreWeave上の連続した仕事として捉える点にある。もし各段階の結果を無理なく次へ渡せるなら、改善を回しやすくなる可能性がある。
ただし、他社の構成との比較資料や、改善周期が実際に短くなったという測定値は提示された範囲にない。読者が現時点で確かめられる到達点は、NVL72の早期アクセス提供とCognitionの本番利用だ。Forgeを含む一連の流れがどこまで実装され、利用者の作業時間や品質にどう効くかは、今後の具体的な運用事例で見極める必要がある。
出典:参照した一次発表(確認日:2026-10-06)。